В марте 2026 года я четыре недели строил распределённую систему с ИИ-агентами. Сам код не писал: прорабатывал бизнес-логику, архитектуру и критерии приёмки, а реализацию и тесты поручал агентам.
Исходный вопрос был простым: как организовать работу с ИИ-агентом, чтобы максимально ускорить разработку ПО? Для поиска ответа я начал Huginn and Muninn — исследовательский проект для сбора сведений о компаниях и анализа сообщений Telegram с помощью LLM.
Проблема организации знаний была мне знакома по прежней работе, поэтому ею мы с агентом занялись одной из первых. Ограничения для агента и способы проверки результата уточнялись уже по ходу эксперимента.
От рабочей задачи к целой системе
В январе 2026 года агент помог мне проверить и доработать сложный алгоритмический механизм: реализовать unit- и интеграционные тесты, найти ошибки в логике и ускорить дальнейшие изменения. Об этом опыте я писал отдельно. Теперь хотелось проверить такой способ работы на создании распределённой системы.
Над Huginn and Muninn я работал один в свободное время: около восьми часов в выходные и двух часов по будням. За четыре недели появились два сервиса на Python, два на .NET и административное приложение на React. Помимо прикладного кода, были подготовлены развёртывание, мониторинг, управление доступом, тесты и утилита разметки для исследования алгоритма анализа чатов.
Масштаб работы виден и в документации: 26 верхнеуровневых и 20 сервисных архитектурных решений, более 250 подробно описанных и закрытых задач GitLab. Эти числа не измеряют выигрыш от применения агента. Но без него подобная работа заняла бы месяцы, а часть описаний пришлось бы опустить ради экономии времени.
Сначала — организация знаний
Общую картину системы трудно восстановить, если сведения о её целях, бизнес-логике и взаимодействии частей разбросаны по разным хранилищам или вообще не документированы. Я сталкивался с этим и раньше. Поэтому в начале проекта мы с агентом рассмотрели несколько вариантов организации документации и быстро выбрали разделение по уровню ответственности.
В корне рабочего пространства находился метарепозиторий с общими правилами и инструкциями агента. Он содержал карту репозиториев и повторяемые процедуры: как планировать и выполнять задачи, фиксировать архитектурные решения, обновлять документацию и тесты.
В отдельном репозитории разместили цели системы, бизнес-логику, архитектуру, описание сервисов и их взаимодействия, общие контракты и сквозные сценарии. Внутреннее устройство каждого сервиса, его схема данных и описания тестов остались рядом с кодом соответствующего сервиса.
Так можно было обсуждать систему целиком, а затем переходить к нужному компоненту, не смешивая общие решения с деталями реализации.
Крупная задача — небольшие контексты
Агент строил план для конечной задачи, а крупную работу мы делили по границам системы: общесистемный уровень и контракты, конкретные сервисы, при необходимости — отдельные части сервиса. Для каждой части определяли свой контекст и критерии приёмки. Сама структура проекта подсказывала такую декомпозицию.
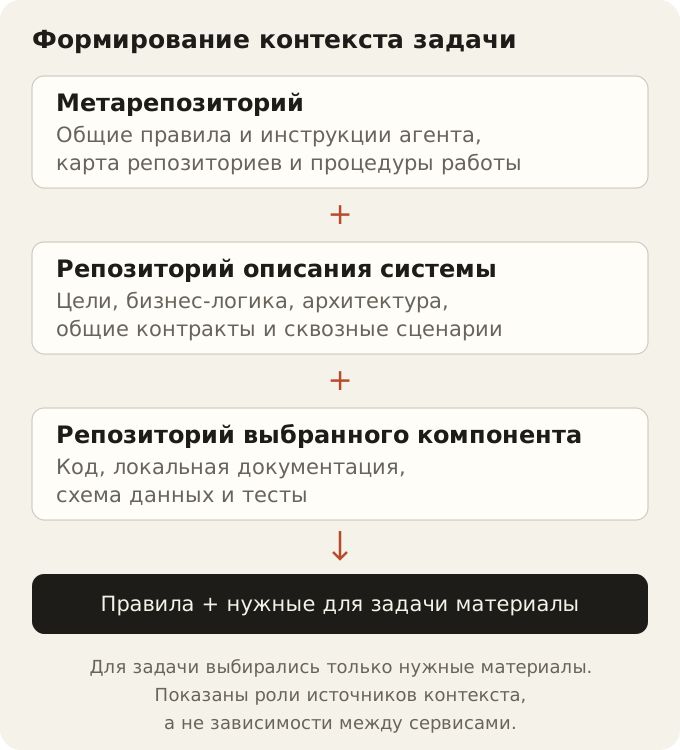
Границы компонентов ограничивали контекст агента. Здесь пригодилась знакомая по микросервисной архитектуре идея: отдельную часть можно разрабатывать, опираясь на её назначение и общие контракты. В контекст попадали относящиеся к задаче материалы и инструкции, а не весь проект. При этом связанные документы нужно было указывать явно, чтобы агент не пропустил важную зависимость.
Документация использовалась как вход реализации. До написания кода мы фиксировали решения, контракты и критерии приёмки. Изменение требования нужно было провести через архитектуру, сценарии и тесты до проверяемого результата. Так описание системы оставалось рабочим инструментом на протяжении разработки.
Что показала работа с агентами
Я не писал код. Моя работа состояла в проработке бизнес-логики, архитектуры, общей структуры кода и критериев приёмки. Агент реализовывал сервисы, интерфейс и тесты по этим критериям. Я просматривал файлы и иногда заглядывал в код, обсуждал выбор библиотек и пакетов, но не тратил время на детали каждой реализации. Если результат соответствовал описанному поведению и проходил тесты, этого было достаточно для следующего шага. Нужной функциональности удавалось добиваться через описание системы и проверку результата.
Незнакомый стек не помешал. До проекта я не писал на Python, а с React давно не работал. Для сбора данных из Telegram и обращения к LLM выбрали Python: его библиотеки лучше подходили для этих задач. Работа с агентом позволила реализовать эти сервисы и React-админку без глубокого погружения в детали стеков.
На отдельных задачах Codex показался мне интереснее. Я сравнивал его с Claude Code на задачах проекта. Codex экономнее расходовал доступные лимиты, а его предложения по архитектуре алгоритма анализа привлекли меня больше.
Для основной разработки хватало лимитов одной подписки. Всего у меня было две подписки на ИИ-агентов по 20 долларов в месяц: одна обычно использовалась для рабочих задач, другая — для Huginn and Muninn. Вероятно, укладываться в лимиты помогало то, что агент работал с контекстом отдельной задачи, а не со всей системой сразу.
Граница эксперимента
Проект с самого начала был исследованием возможностей разработки с ИИ-агентами. Запроса на эту функциональность от конкретной аудитории не было. Поиск пользователей, сбор их требований и подготовку к эксплуатации я оставил за рамками эксперимента. Позже появились другие задачи, поэтому к запуску системы я не возвращался.
Этот опыт относится к разработке и созданным инженерным артефактам; внедрение и поддержку в эксплуатации я здесь не проверял.
Я был впечатлён объёмом и качеством выполненной работы. По сути, я выступал архитектором: задавал устройство и поведение системы, а агент помог построить и описать не самую простую распределённую систему за четыре недели. Основная работа для меня сосредоточилась на том, что система должна делать, как разделить задачу и по каким признакам принять результат.