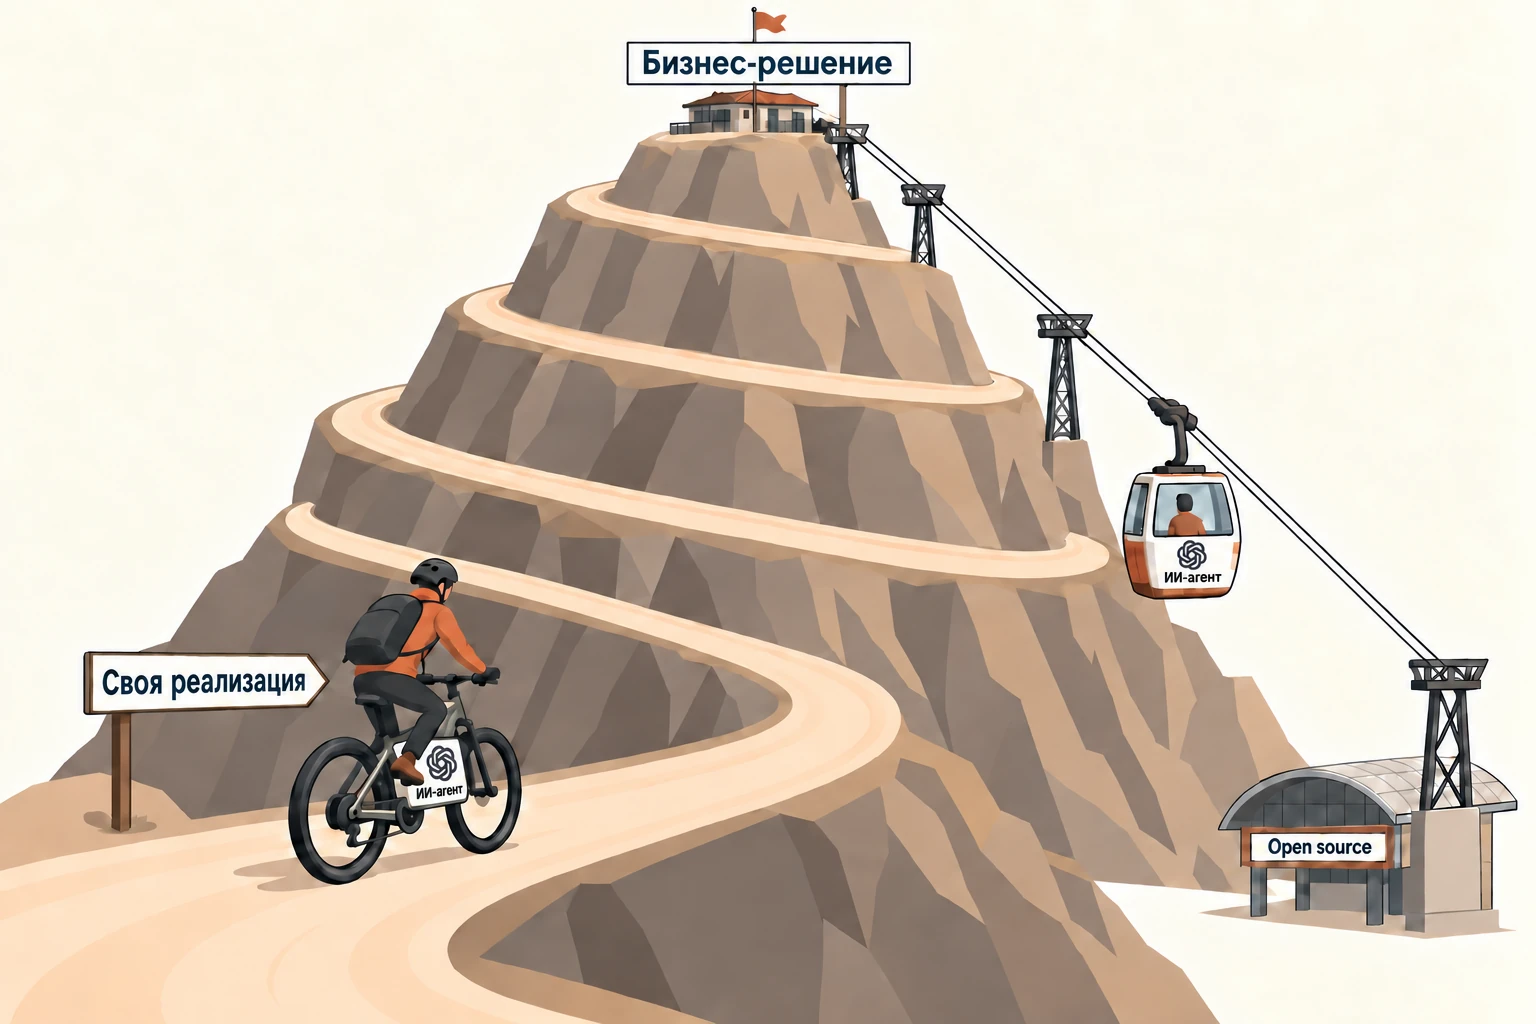
В работе с ИИ-агентом готовые open source компоненты оказались ещё полезнее, чем я ожидал. Дело не только в том, что не пришлось писать их самому. Популярные библиотеки и типовые способы их применения обычно уже знакомы модели, на которой работает агент. Поэтому ему не нужно каждый раз изучать их с нуля: можно сразу обсуждать, как использовать готовые возможности в нашей системе.
Собственный компонент агент тоже может изучить самостоятельно. Но его устройство, внутренние соглашения и ограничения сначала нужно выяснить по коду и документации. Это дополнительная работа, объём которой зависит ещё и от качества описаний и тестов.
Это наблюдение появилось при разработке Huginn and Muninn — исследовательской системы для сбора сведений о компаниях и анализа сообщений Telegram с помощью LLM. Я прорабатывал бизнес-логику, архитектуру и критерии приёмки, а реализацией и тестами занимались агенты. Об организации этой работы я уже писал. Здесь хочу отдельно разобрать выбор между готовым компонентом и собственной реализацией.
Цена освоения и интеграции меняется
В рабочих проектах я не раз сталкивался с собственными системами учёта пользователей и разграничения доступа. Встречались и свои шлюзы, и дополнительные конструкции поверх HTTP: обычный JSON превращался во внутренний формат, передавался дальше и снова преобразовывался.
Не все такие решения были лишними. Иногда небольшой собственный компонент оказывался проще готового продукта и лучше встраивался в существующую систему. У готового инструмента тоже есть цена: его нужно настроить, связать с остальными частями, проверить интеграцию и затем сопровождать.
Агент меняет стоимость освоения и интеграции. Я могу описать требования к системе, а агент — подготовить интеграцию, опираясь на уже знакомые модели интерфейсы и подходы. Мне не нужно сначала самому становиться специалистом по каждому инструменту, а агенту — начинать с его полного изучения. Поэтому аргумент «своё написать быстрее, чем разбираться в чужом» становится менее убедительным.
Не два удачных компонента, а основа проекта
Keycloak и шлюз — наглядные примеры, но на готовые библиотеки опирался весь проект: от взаимодействия с Telegram до хранения данных и административного интерфейса.
Для Telegram и HTTP API использовались Telethon и FastAPI. Сервис получал сообщения через готовую библиотеку, а HTTP-интерфейс строился на готовом фреймворке. До этого проекта я не писал на Python. Мы выбрали его из-за подходящих инструментов для задач сервисов, а не потому, что это был привычный мне язык. Незнакомый стек не потребовал от меня сначала стать специалистом по каждой библиотеке.
Доступ к данным и обмен сообщениями тоже строились на готовых компонентах. В Python-сервисах использовалась SQLAlchemy, в .NET — Entity Framework Core с PostgreSQL. Сообщения передавались через RabbitMQ; для работы с ним в стеках были aio-pika и Wolverine. Схему данных, границы сервисов и смысл сообщений всё равно нужно было определить. Готовые компоненты давали основу для реализации этих решений.
В админке готовые компоненты соединялись друг с другом. Интерфейс
реализовали на React, хотя я давно с ним не работал. Для входа
использовали Keycloak, а на стороне React — oidc-client-ts
и react-oidc-context. Возможностей Keycloak хватило с запасом:
вход, роли и разграничение доступа к функциям админки не потребовали
собственной системы управления пользователями.
Шлюз также не пришлось писать с нуля. Для него выбрали Caddy в связке с oauth2-proxy. Вместо реализации своего шлюза мы настраивали маршрутизацию, проверку доступа и передачу нужного контекста сервисам. Работа оставалась, но это была работа по интеграции готовых компонентов под требования системы.
Общий результат важнее любого отдельного названия. Я мог обсуждать с агентом, какие данные нужны сервису, кто имеет право выполнить операцию и как части системы должны взаимодействовать. Мне не приходилось погружаться в детали каждой библиотеки: с ними работал агент, а я сосредоточился на требованиях и архитектуре.
Что даёт открытая экосистема
Первое преимущество — знания, которые уже есть у модели. С популярной библиотекой агенту не требуется отдельный вводный курс по её назначению, основным интерфейсам и типовым способам применения. В задаче можно сосредоточиться на том, какие данные нужны нашей системе, какое поведение требуется и как выбранный компонент должен в неё встроиться.
Второе — доступные материалы для уточнения и проверки. Если нужно проверить особенности конкретной версии или разобраться с нетипичным сценарием, агент может обратиться к документации, примерам и исходному коду. Тесты помогают проверить поведение. Это дополнение к уже имеющимся знаниям, а не обязательное изучение каждого компонента с нуля.
Самописный компонент агент тоже может изучить самостоятельно. Необязательно пересказывать ему его устройство — можно дать доступ к репозиторию и поручить разобраться. Но общие знания о программировании не заменяют знания внутренних контрактов конкретной системы. Во внутренних разработках я сталкивался с неполной документацией или её отсутствием, кодом, в котором трудно разобраться, и неполным тестовым покрытием. Встречались и компоненты вообще без тестов.
В такой ситуации часть работы уходит на восстановление контрактов и ограничений. По коду можно увидеть, как компонент работает сейчас, но не всегда понять, какое поведение задумано, а какое оказалось случайным или ошибочным. Если нужные сценарии не описаны и не покрыты тестами, основания для проверки придётся создавать отдельно. Поручить эту работу агенту можно, но сама работа от этого не исчезает.
Поэтому для выбора важен не только открытый исходный код. Важны зрелость инструмента, понятная документация, стандартные интерфейсы и соответствие задаче. Малоизвестный проект без примеров не получает автоматически те же преимущества, что распространённая библиотека. А собственный компонент с понятным кодом, актуальными описаниями и хорошими тестами тоже даёт агенту надёжную основу для работы.
Агент упрощает и написание собственного кода. Но быстро получить первую версию — не то же самое, что избавить себя от её дальнейшего развития и поддержки. Готовые компоненты позволяют не брать на себя часть этой работы, хотя их выбор, настройка, обновления и проверка интеграции никуда не исчезают.
Собственная работа — там, где задача действительно своя
Huginn and Muninn не стал системой без собственного кода. Нужно было определить бизнес-логику, связи данных, алгоритм анализа сообщений, контракты сервисов и правила доступа. Именно этим я и занимался. Агент реализовывал описанное поведение, используя готовые инструменты.
Теперь при выборе компонента я смотрю не только на то, насколько быстро его можно написать с агентом, но и на то, зачем вообще брать его реализацию на себя. Важно учитывать не только готовый код, но и то, что модель уже знает о его применении и какие материалы доступны для уточнения и проверки. Если подходящее решение существует и агент может опереться на эти знания при интеграции, собственную разработку стоит направить на особенности своей системы. В этом проекте сочетание open source и ИИ-агента позволило мне работать прежде всего с задачей и архитектурой, а не с деталями каждого инструмента.